AI দিয়ে সিদ্ধান্ত নিতে আসলে কতটুকু AI লাগে?
Jev, Decision Model, calibration আর specialized inference থেকে শেখা — classification বা scoring - এর জন্য আসলে কতটুকু AI capability দরকার?
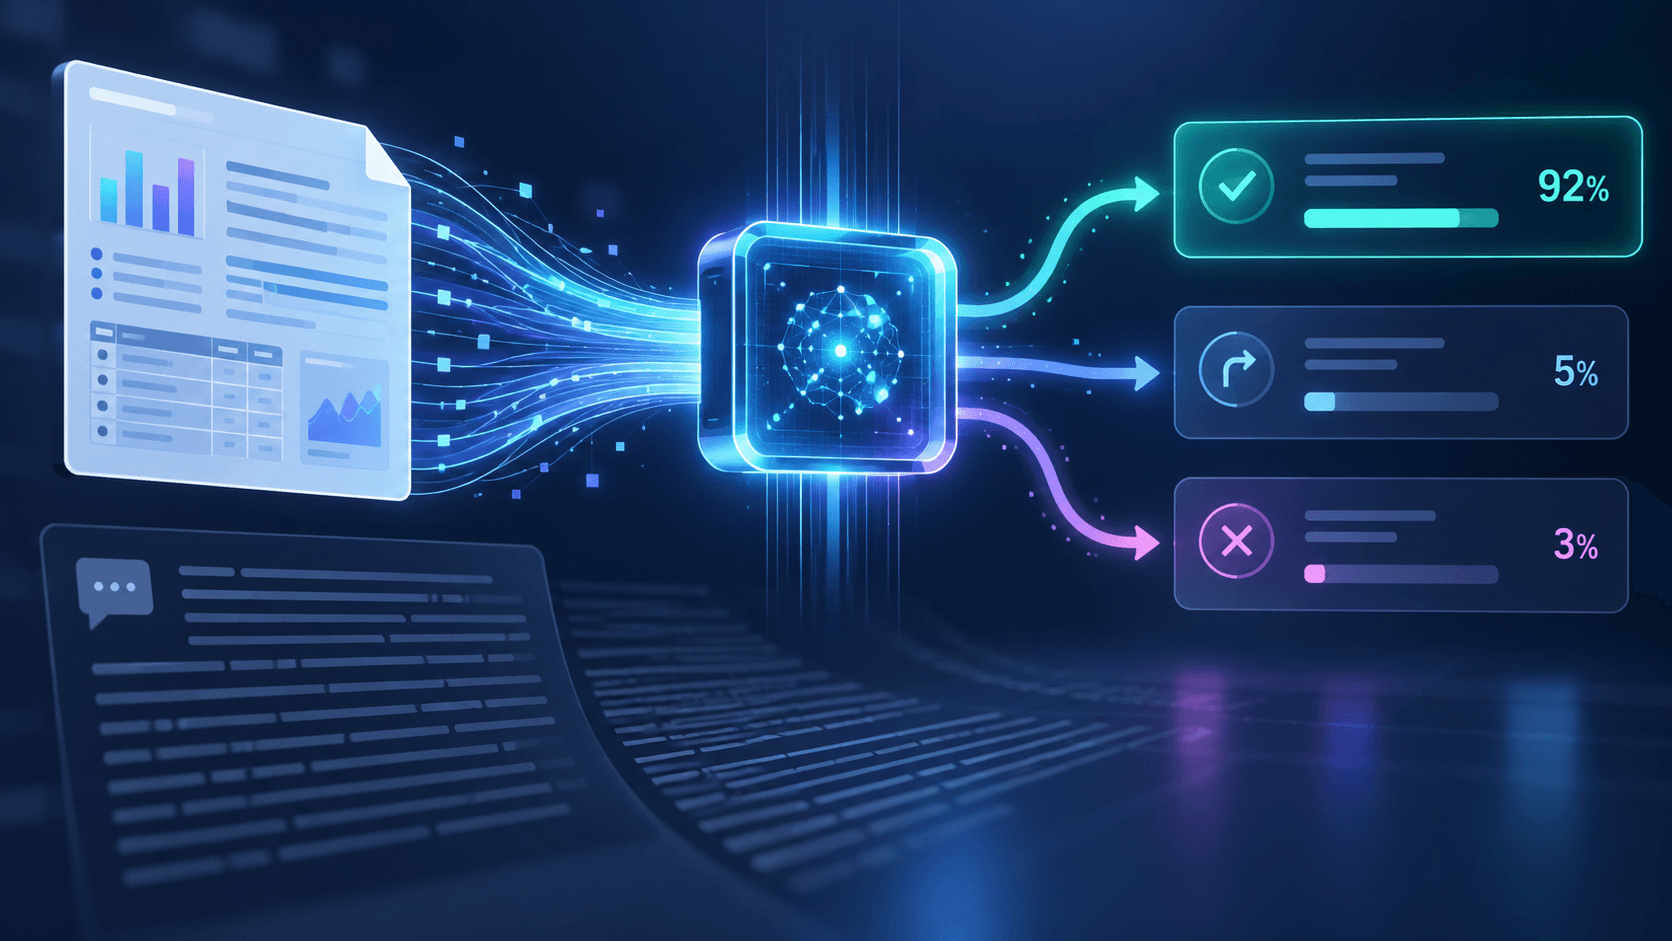
ধরেন আপনি একটা কোম্পানির জন্য AI-based customer support system বানাচ্ছেন।
প্রতিদিন হাজার হাজার customer support ticket আসে। কোনোটা payment নিয়ে, কোনোটা refund নিয়ে, কোনোটা technical issue।
আপনার কাজ হচ্ছে এই ticket গুলা পড়ে কোনটা কোন department-এ যাবে সেটা decide করা।
এখন আপনি চাইলে একটা LLM ব্যবহার করতে পারেন। যেমন GPT, Claude কিংবা Qwen।
প্রতিটা ticket AI-কে পাঠাবেন, সাথে একটা prompt দিবেন। AI পুরো ticket পড়ে আপনাকে বলে দিবে কোন department-এ পাঠাতে হবে।
কাজ শেষ!
কিন্তু একটু চিন্তা করেন।
আপনার আসলে AI থেকে কী দরকার ছিল?
একটা ticket কোন department-এ যাবে, এই সিদ্ধান্তটা।
অথচ এই ছোট্ট সিদ্ধান্ত নেওয়ার জন্য আপনি একটা বিশাল language model ব্যবহার করতেছেন। Model text generate করতেছে, response parse করতেছেন, token-এর জন্য টাকা দিচ্ছেন।
আবার AI হয়তো বলতেছে, "Based on the customer's description, I believe this issue should be handled by the billing department."
এত কথা তো আপনার দরকারই ছিল না!
শুধু billing বললেই হতো।
আরেকটু ভালো হলে, billing department-এ যাওয়ার probability কতটুকু, সেটাও বলে দিত।
এই সমস্যাটা সমাধান করার জন্য TypeSafe নামের একটা কোম্পানি Jev নামে একটা AI model তৈরি করেছে।
Jev হচ্ছে একধরনের Decision Model।
এটা ChatGPT-এর মতো আপনার সাথে গল্প করবে না, essay লিখবে না, code generate করবে না।
এর কাজ হচ্ছে সিদ্ধান্ত নেওয়া।
আপনি একটা document দিবেন, কয়েকটা প্রশ্ন করবেন, প্রতিটা প্রশ্নের জন্য কিছু possible answer দিবেন।
Jev আপনাকে জানাবে কোন answer-এর probability কত।
এবং মজার ব্যাপার হচ্ছে, এই কাজটা করার জন্য model-কে একটা শব্দও generate করতে হয় না!
AI একটা উত্তর দেওয়ার জন্য আসলে কী করে?#
বিষয়টা বুঝতে হলে LLM কীভাবে কাজ করে সেটা একটু বুঝতে হবে।
আমরা যখন ChatGPT-কে কিছু জিজ্ঞেস করি, তখন model একসাথে পুরো উত্তরটা তৈরি করে না।
একটা একটা করে token predict করে।
ধরেন আপনি জিজ্ঞেস করলেন, বাংলাদেশের রাজধানী কোথায়?
Model প্রথমে একটা token predict করবে, তারপর পরেরটা, তারপর তার পরেরটা।
এভাবে পুরো উত্তর তৈরি হবে।
এই process-টাকে বলে autoregressive generation।
কিন্তু model যখন পরবর্তী token predict করে, তখন সে আসলে শুধু একটা token-এর নাম বের করে না।
সে তার vocabulary-তে থাকা অসংখ্য token-এর একটা করে score calculate করে। এই score-কে বলা হয় logit।
তারপর সেই score থেকে probability বের করে পরবর্তী token বেছে নেওয়া হয়।
এখন ধরেন, আপনার কাছে তিনটা possible answer আছে।
billing, sales, technical_support
আপনার তো আর নতুন কোনো text generate করার দরকার নেই।
Model যদি বলে:
- Billing: 92%
- Sales: 3%
- Technical Support: 5%
তাহলেই তো কাজ হয়ে যাচ্ছে!
Decision Model মূলত এই ধারণাটাকেই কাজে লাগায়।
Model-এর output generate করার আগেই তার internal scores ব্যবহার করে সিদ্ধান্ত নেওয়া হয়।
তবে এখানে একটা গুরুত্বপূর্ণ বিষয় আছে।
সাধারণ LLM-এর vocabulary-তে থাকা token দিয়েই এই কাজ করলে কিছু সমস্যা হয়। যেমন, A, B, C দিয়ে option চিহ্নিত করলে model-এর আগের training থেকে শেখা bias সিদ্ধান্তে প্রভাব ফেলতে পারে।
তাই আলাদা reserved token ব্যবহার করা যায়।
যেমন <opt_0>, <opt_1>, <opt_2>।
আর prompt-এর শেষে একটা special readout token রাখা হয়।
Model সেই position-এ কোন option কতটা সম্ভাবনাময় সেটা calculate করে।
এরপর শুধু ওই option token-গুলোর logits নিয়ে softmax করলেই probability পাওয়া যায়।
কোনো text generation দরকার নেই।
এখন প্রশ্ন হচ্ছে, একটা সাধারণ LLM তো এমনিতেই বিভিন্ন option-এর probability বের করতে পারে। তাহলে নতুন করে Decision Model train করার দরকার কী?
কারণ সাধারণ LLM-কে আমরা মূলত পরের token predict করার জন্য train করেছি।
কিন্তু এখানে আমরা চাই, model যেন নির্দিষ্ট একটা decision সঠিকভাবে নিতে শেখে।
তাই training-এর সময় তাকে শেখানো হয় কোন input-এর জন্য কোন option সঠিক, এবং তার confidence কীভাবে প্রকাশ করতে হবে।
এই জায়গাতেই fine-tuning কাজে আসে।
একটা document, ৫০টা প্রশ্ন, কিন্তু বারবার document পড়ার দরকার কী?#
Decision Model-এর সবচেয়ে interesting engineering বিষয়গুলোর একটা হচ্ছে এর inference architecture।
ধরেন আপনার কাছে একটা ২০ হাজার token-এর document আছে।
সেই document থেকে আপনি ৫০টা প্রশ্নের উত্তর জানতে চান।
সাধারণভাবে প্রতিটা প্রশ্নের জন্য document-টা আবার model-কে পাঠাতে পারেন।
অর্থাৎ ৫০ বার একই document ব্যবহার করতেছেন!
এখানে prefix caching ব্যবহার করলে model-কে একই document-এর computation বারবার করতে হয় না।
কিন্তু তারপরও server-side processing, cache lookup, scheduling-এর একটা overhead থেকে যায়।
বিশেষ করে document বড় হলে এবং প্রশ্নের সংখ্যা বেশি হলে।
এখন চিন্তা করেন, যদি document-টা মাত্র একবার process করা যায়, আর ৫০টা প্রশ্নের উত্তরও একসাথে বের করা যায়?
এখানেই আসে Tree Batching।
আইডিয়াটা হচ্ছে, document-কে common context হিসেবে রাখা হবে।
তারপর প্রতিটা প্রশ্ন আলাদা branch হিসেবে process হবে।
কিন্তু একটা প্রশ্ন যেন অন্য প্রশ্নের context দেখতে না পারে, সেজন্য custom attention mask ব্যবহার করা হবে।
অর্থাৎ প্রতিটা প্রশ্ন document এবং নিজের প্রশ্নের tokens দেখতে পারবে, অন্য প্রশ্নের tokens দেখতে পারবে না।
এভাবে একটা forward pass-এই সব প্রশ্নের readout position থেকে answer বের করা সম্ভব।
এটা কিন্তু শুধু prompt engineering না।
Inference engine-এর attention masking, position IDs এবং sequence processing-এর মতো বিষয়গুলো এখানে গুরুত্বপূর্ণ।
আর এর ফলে একই document বারবার process করার overhead অনেক কমে যায়।
বিশেষ করে যেখানে একটা বড় document থেকে অনেকগুলো ছোট ছোট decision নিতে হয়, সেখানে এই architecture বেশ interesting।
যেমন invoice processing, fraud detection, support ticket routing, document classification কিংবা compliance checking।
AI বলল ৯৫% sure। কিন্তু আসলেই কি ৯৫%?#
এখন আরেকটা সমস্যা আছে।
ধরেন AI একটা transaction দেখে বলল, এটা fraud হওয়ার probability 95%।
আপনি সেই transaction block করে দিলেন।
কিন্তু AI-এর 95% confidence-এর আসলে মানে কী?
ধরেন, model ১০০টা transaction-এর ক্ষেত্রে 95% confidence দেখিয়েছে।
এর মধ্যে যদি সত্যিই প্রায় ৯৫টা ক্ষেত্রে তার সিদ্ধান্ত সঠিক হয়, তাহলে তার confidence-কে মোটামুটি calibrated বলা যায়।
কিন্তু যদি ১০০টার মধ্যে মাত্র ৭০টা সঠিক হয়?
তাহলে 95% confidence দেখিয়ে কী লাভ!
এই জায়গায় Decision Model-এর জন্য Calibration খুব গুরুত্বপূর্ণ।
কারণ এখানে model-এর probability শুধু দেখানোর জন্য না। সেই probability ব্যবহার করেই বাস্তবে সিদ্ধান্ত নেওয়া হতে পারে।
যেমন, fraud probability 90%-এর বেশি হলে transaction block করতে হবে।
অথবা customer complaint-এর confidence 80%-এর কম হলে human review-তে পাঠাতে হবে।
এক্ষেত্রে একটা বহুল ব্যবহৃত technique হচ্ছে temperature scaling।
এটা model-এর logits adjust করে probability distribution-কে কম বা বেশি confident করতে পারে।
কিন্তু temperature scaling দিয়ে সব সমস্যা সমাধান হয় না।
ধরেন একটা model payment fraud detection-এ খুব ভালো, কিন্তু customer sentiment analysis-এ বাজে confidence দেয়।
সব task-এর জন্য একই temperature ব্যবহার করলে সমস্যা থেকেই যাবে।
আরেকটা বিষয় হচ্ছে training data।
যেখানে প্রকৃত উত্তরটা অনিশ্চিত, সেখানে model-কে সবসময় একটা নির্দিষ্ট answer সঠিক হিসেবে শেখালে সে প্রয়োজনের চেয়ে বেশি confident হয়ে যেতে পারে।
এক্ষেত্রে training label-এর মধ্যেও uncertainty রাখা দরকার।
অর্থাৎ AI-কে শুধু সঠিক সিদ্ধান্ত নেওয়া শেখালেই হবে না, কখন কতটুকু নিশ্চিত হওয়া উচিত, সেটাও শেখাতে হবে।
Jev আসলে কোন AI model দিয়ে বানানো?#
এবার আসি আরেকটা interesting বিষয়ে।
TypeSafe তাদের Jev model-এর পুরো architecture কিংবা base model public করেনি।
তাহলে Jev আসলে কী দিয়ে তৈরি?
Oumi-র দুই researcher Jeremy Greer এবং Matthew Persons এই বিষয়টা বের করার চেষ্টা করেছেন।
তারা Jev-এর API ব্যবহার করে বিভিন্ন পরীক্ষা করেছেন।
যেমন, model-কে নিজের পরিচয় সম্পর্কে প্রশ্ন করা, বিভিন্ন token-এর count পরীক্ষা করা, কঠিন প্রশ্নে performance দেখা, এমনকি কিছু নির্দিষ্ট বিষয়ে model-এর bias পরীক্ষা করা।
তাদের গবেষণা থেকে একটা interesting hypothesis এসেছে।
Jev সম্ভবত Qwen 3.5 কিংবা Qwen 3.6-এর 35B-A3B model-এর ওপর ভিত্তি করে তৈরি।
এটা নিশ্চিত তথ্য না। তাদের experimental findings থেকে পাওয়া সবচেয়ে সম্ভাব্য ব্যাখ্যা।
কিন্তু তারা এই ধারণায় পৌঁছালেন কীভাবে?
প্রথমত, Jev-এর token counting behavior বিশ্লেষণ করে Qwen 3.5-এর tokenizer-এর সাথে বেশ শক্তিশালী মিল পাওয়া গেছে।
দ্বিতীয়ত, Jev বিভিন্ন uncommon factual question-এ Qwen-এর কাছাকাছি performance দেখিয়েছে।
তৃতীয়ত, দুটো model শুধু একই প্রশ্নের সঠিক উত্তর দেয় না, অনেক ক্ষেত্রে একই ভুলও করে!
এই বিষয়টা কিন্তু বেশ গুরুত্বপূর্ণ।
কারণ একটা model-কে fine-tune করলে তার behavior পরিবর্তন করা যায়, কিন্তু আগে থেকে শেখা সব knowledge বদলে যায় না।
ফলে base model-এর কিছু বৈশিষ্ট্য নতুন model-এ থেকে যেতে পারে।
এমনকি কিছু bias-ও।
Oumi-র researchers বিভিন্ন politically sensitive প্রশ্নেও Jev এবং Qwen-এর মধ্যে মিল পেয়েছেন।
এটা AI engineering-এর জন্য একটা গুরুত্বপূর্ণ reminder।
আপনি একটা open-source model নিয়ে fine-tune করলেন, নতুন নাম দিলেন, নতুন task শেখালেন।
তাতে কিন্তু model-এর আগের সব bias কিংবা knowledge limitation magically চলে যাচ্ছে না।
তাই production system বানানোর সময় base model selection খুব গুরুত্বপূর্ণ।
কিন্তু Jev তো reasoning করছে না। তাহলে কঠিন প্রশ্নের উত্তর দিচ্ছে কীভাবে?#
এই অংশটা আমার কাছে সবচেয়ে interesting লেগেছে।
আমরা এখন AI model-এর reasoning capability বাড়ানোর দিকে অনেক বেশি focus করতেছি।
কোনো model যত বেশি চিন্তা করতে পারে, অনেক ক্ষেত্রে তত ভালো উত্তর দিতে পারে।
কিন্তু reasoning করতে সময় লাগে, token লাগে, computing power লাগে।
Jev সেই কাজটাই করছে অনেকটা উল্টোভাবে।
সে reasoning-এর text generate করছে না।
অথচ Oumi-র পরীক্ষায় দেখা গেছে, বেশ কিছু কঠিন প্রশ্নে Jev-এর performance খুব ভালো।
তাদের MMLU-Pro পরীক্ষায় Jev-এর accuracy ছিল 83%।
একই পরীক্ষায় reasoning বন্ধ রেখে Qwen3.5-35B-A3B-এর accuracy ছিল 60%।
অথচ Jev প্রতিটা প্রশ্নের উত্তর দিয়েছে একটা forward pass-এ।
এটা কীভাবে সম্ভব?
একটা সম্ভাব্য ব্যাখ্যা হচ্ছে distillation।
ধরেন আপনার কাছে একটা powerful reasoning model আছে।
সে একটা কঠিন mathematical problem solve করার জন্য অনেকগুলো reasoning step ব্যবহার করল।
এবার আপনি সেই problem এবং তার সঠিক answer দিয়ে একটা ছোট model-কে train করলেন।
এভাবে অনেকগুলো problem-এর ওপর training করালে model ধীরে ধীরে কিছু প্রশ্নের উত্তর সরাসরি predict করতে শিখতে পারে।
প্রতিবার তাকে একই reasoning process generate করতে হয় না।
অবশ্যই এর limitation আছে।
নতুন কিংবা জটিল সমস্যায় explicit reasoning দরকার হতে পারে। আর Jev-ও সব ধরনের প্রশ্নে সমান ভালো না।
তবে idea-টা interesting।
কারণ অনেক production application-এ আমাদের AI-এর reasoning process দেখানোর দরকার নেই।
আমাদের দরকার সঠিক সিদ্ধান্ত, predictable latency এবং reasonable cost।
সেক্ষেত্রে একটা ভালোভাবে trained specialized model অনেক সময় general-purpose reasoning model-এর চেয়ে practical হতে পারে।
তাহলে নিজেরাও এমন model বানাতে পারব?#
সম্ভব।
তবে এখানে দুইটা বিষয় আলাদা করা দরকার।
একটা হচ্ছে নিজের use case-এর জন্য specialized decision model তৈরি করা।
আরেকটা হচ্ছে Jev-এর মতো optimized production inference system তৈরি করা।
প্রথমটা তুলনামূলক সহজ।
ধরেন আপনি invoice processing-এর জন্য একটা model বানাবেন।
আপনার কাছে আগের কয়েক লাখ invoice-এর data আছে, যেখানে কোন invoice approved হয়েছে, কোনটা rejected হয়েছে, কোথায় manual review লেগেছে, সেই তথ্যগুলোও আছে।
আপনি একটা ছোট open-source LLM নিয়ে এই data-তে fine-tune করতে পারেন।
Model-কে predefined option-এর ওপর probability দিতে train করতে পারেন।
তারপর calibration পরীক্ষা করতে পারেন।
কিন্তু Jev-এর মতো efficient serving infrastructure বানাতে গেলে কাজটা আর শুধু fine-tuning-এর মধ্যে সীমাবদ্ধ থাকবে না।
সেখানে custom inference optimization, batching strategy, attention mask, GPU utilization-এর মতো বিষয়গুলো আসবে।
আর একটা বিষয় হচ্ছে TypeSafe তাদের training approach-কে RLCD বা Reinforcement Learning for Calibrated Decisions বলছে।
তারা এর বিস্তারিত public research paper প্রকাশ করেনি।
তাই এর ভেতরে ঠিক কোন training algorithm ব্যবহার করা হয়েছে সেটা নিশ্চিতভাবে বলা যাচ্ছে না।
Oumi-র researchers-এর ধারণা, appropriately labeled data এবং conventional training technique দিয়েও একই ধরনের অনেক সুবিধা পাওয়া সম্ভব।
এটা সত্যি হলে specialized decision model বানানোর জন্য নতুন কোনো reinforcement learning algorithm আবিষ্কার করার প্রয়োজন নেই।
তাহলে আমাদের কী শেখার আছে?#
আমার কাছে পুরো বিষয়টার সবচেয়ে interesting দিক হচ্ছে, আমরা AI ব্যবহার করার সময় অনেক ক্ষেত্রেই ধরে নিচ্ছি যে একটা বড় LLM লাগবে।
AI মানেই prompt, reasoning, text generation, output parsing।
কিন্তু সব সমস্যার জন্য এগুলো কি আসলেই দরকার?
ধরেন আপনার একটা application-এ প্রতিদিন ১ লাখ transaction process হয়।
প্রতিটা transaction-এর জন্য আপনাকে মাত্র তিনটা সিদ্ধান্ত নিতে হবে।
Transaction suspicious কি না।
Manual review লাগবে কি না।
আর কোন risk category-তে পড়বে।
এখন এই কাজের জন্য প্রতিবার একটা general-purpose language model দিয়ে কয়েকশ token generate করানো কতটা যুক্তিযুক্ত?
একটা traditional ML classifier দিয়েও হয়তো কাজটা করা সম্ভব।
আবার কিছু ক্ষেত্রে document-এর complicated context বোঝার জন্য LLM-এর capability দরকার হতে পারে।
সেখানে specialized decision model interesting একটা middle ground হতে পারে।
অর্থাৎ LLM-এর language understanding capability ব্যবহার করবেন, কিন্তু conversational response generation-এর overhead বাদ দিবেন।
এখানে একটা বিষয় মাথায় রাখা দরকার—Jev-এর মতো model সব ধরনের AI application-এর replacement না।
যেখানে নতুন কিছু লিখতে হবে, code generate করতে হবে, complex reasoning দেখাতে হবে, সেখানে generative model দরকার থাকবে।
কিন্তু যেখানে কাজটা মূলত classification, scoring কিংবা predefined options থেকে সিদ্ধান্ত নেওয়া, সেখানে approach-টা ভিন্ন হতে পারে।
আমরা এখন বেশিরভাগ সময় চিন্তা করি, কোন AI model সবচেয়ে powerful।
কিন্তু production engineering-এ অনেক সময় আরো গুরুত্বপূর্ণ প্রশ্ন হচ্ছে—
এই কাজটা করার জন্য আসলে কতটুকু AI capability দরকার?
কারণ আপনার যদি শুধু একটা সিদ্ধান্ত দরকার হয়, তাহলে সেই সিদ্ধান্ত নেওয়ার জন্য AI দিয়ে একটা পুরো paragraph লেখানোর কোনো মানে নেই।